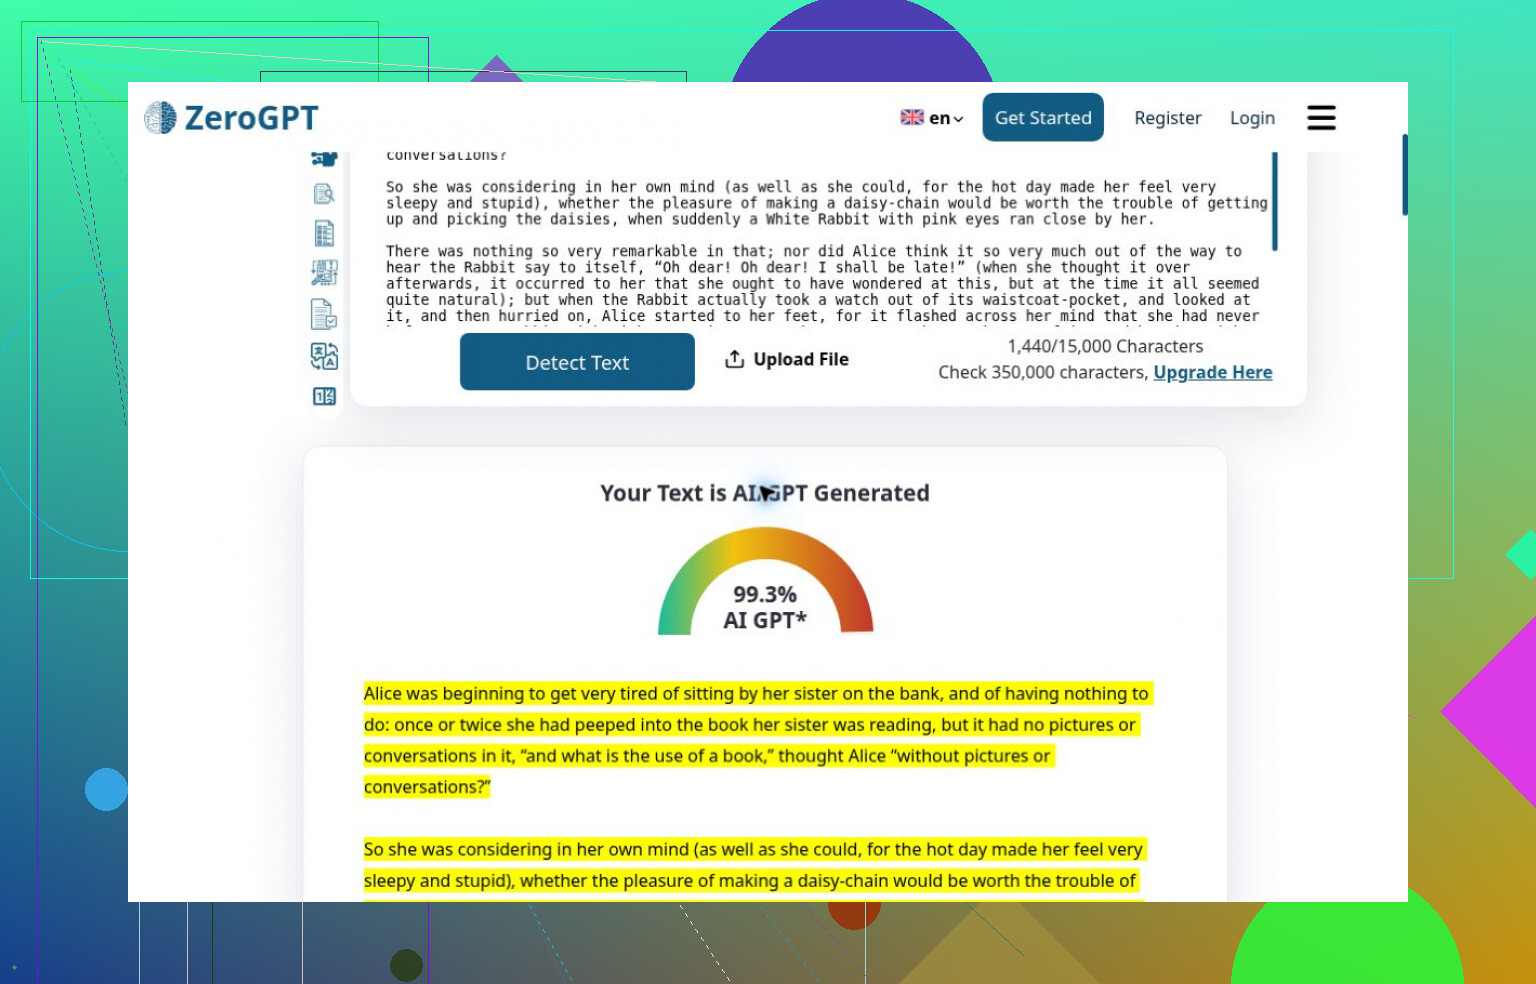
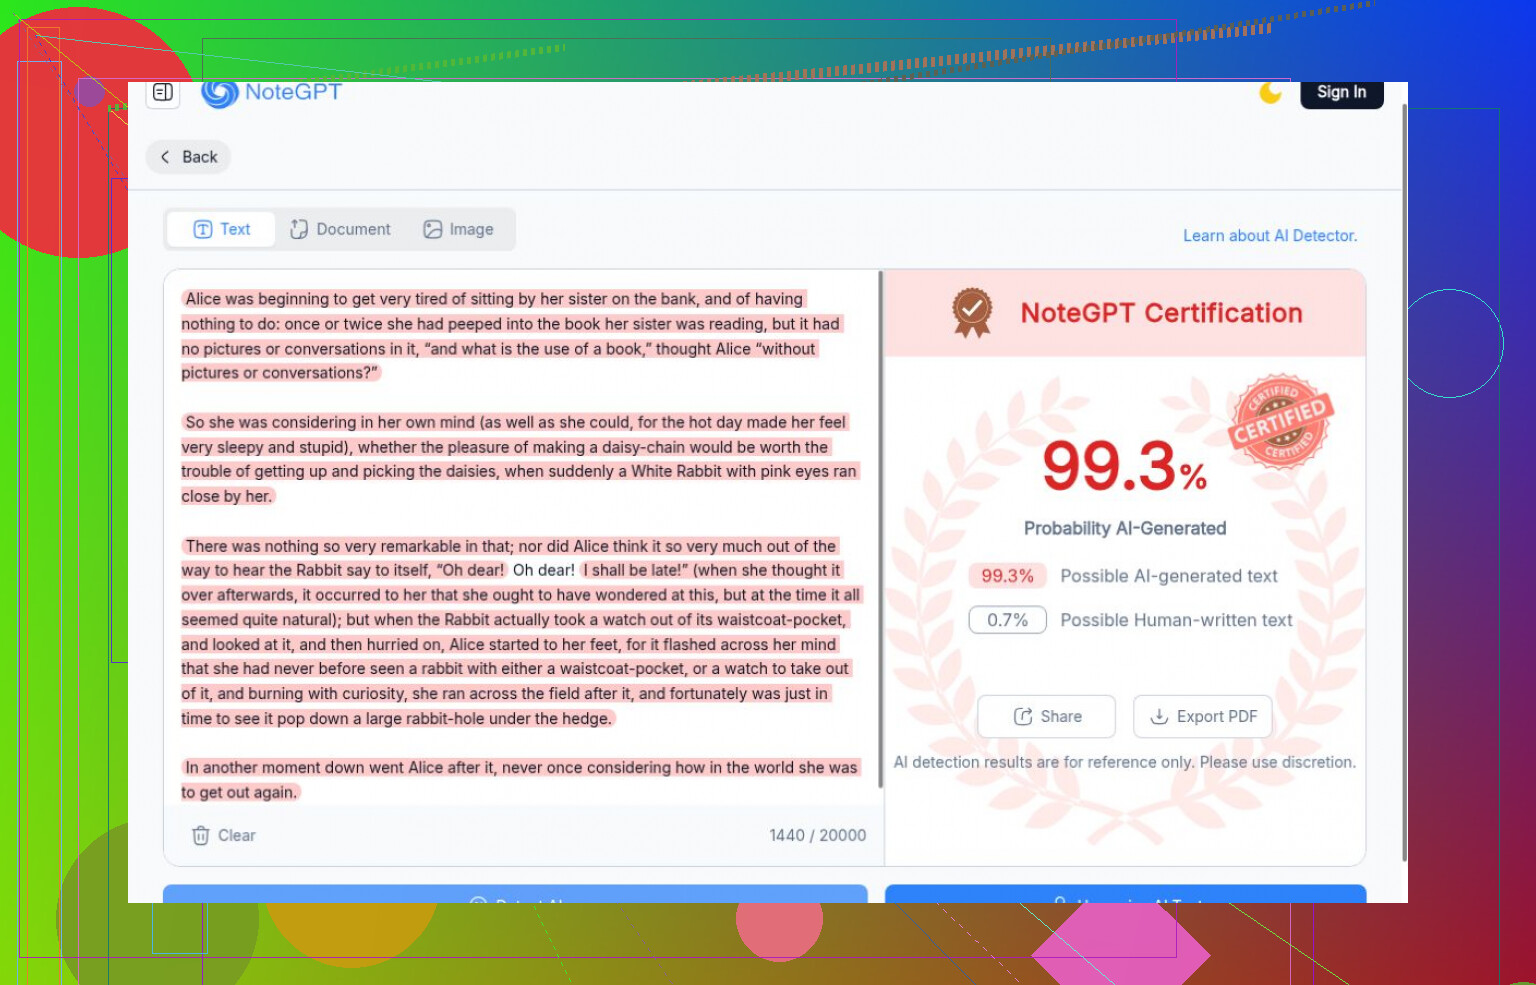
99,3 % de IA fue el veredicto de ZeroGPT sobre Lewis Carroll. El texto humano de control obtuvo una puntuación superior a la de todos los pasajes generados que envié. Ese es el resultado que comprobaría antes de confiar en la clasificación tajante de un detector.
Lo que realmente pude comparar
Reutilicé seis pasajes en inglés sin modificarlos: textos generados en distintos formatos, un fragmento de Carroll y una versión de ese fragmento editada con IA. Algunas muestras estaban relacionadas, así que no consideraría esto un estudio amplio de precisión.
Conté las comprobaciones completadas, no los envíos bloqueados ni las puntuaciones residuales. También separé los problemas de acceso de los fallos de detección. Una pantalla de registro no me dice nada sobre si un detector funciona.
Donde los resultados dejaron de cuadrar
ZeroGPT detectó los textos generados, pero falló con el texto humano de control. NoteGPT también asignó a Carroll su puntuación de IA más alta. Que las puntuaciones coincidan no demuestra que compartan tecnología.
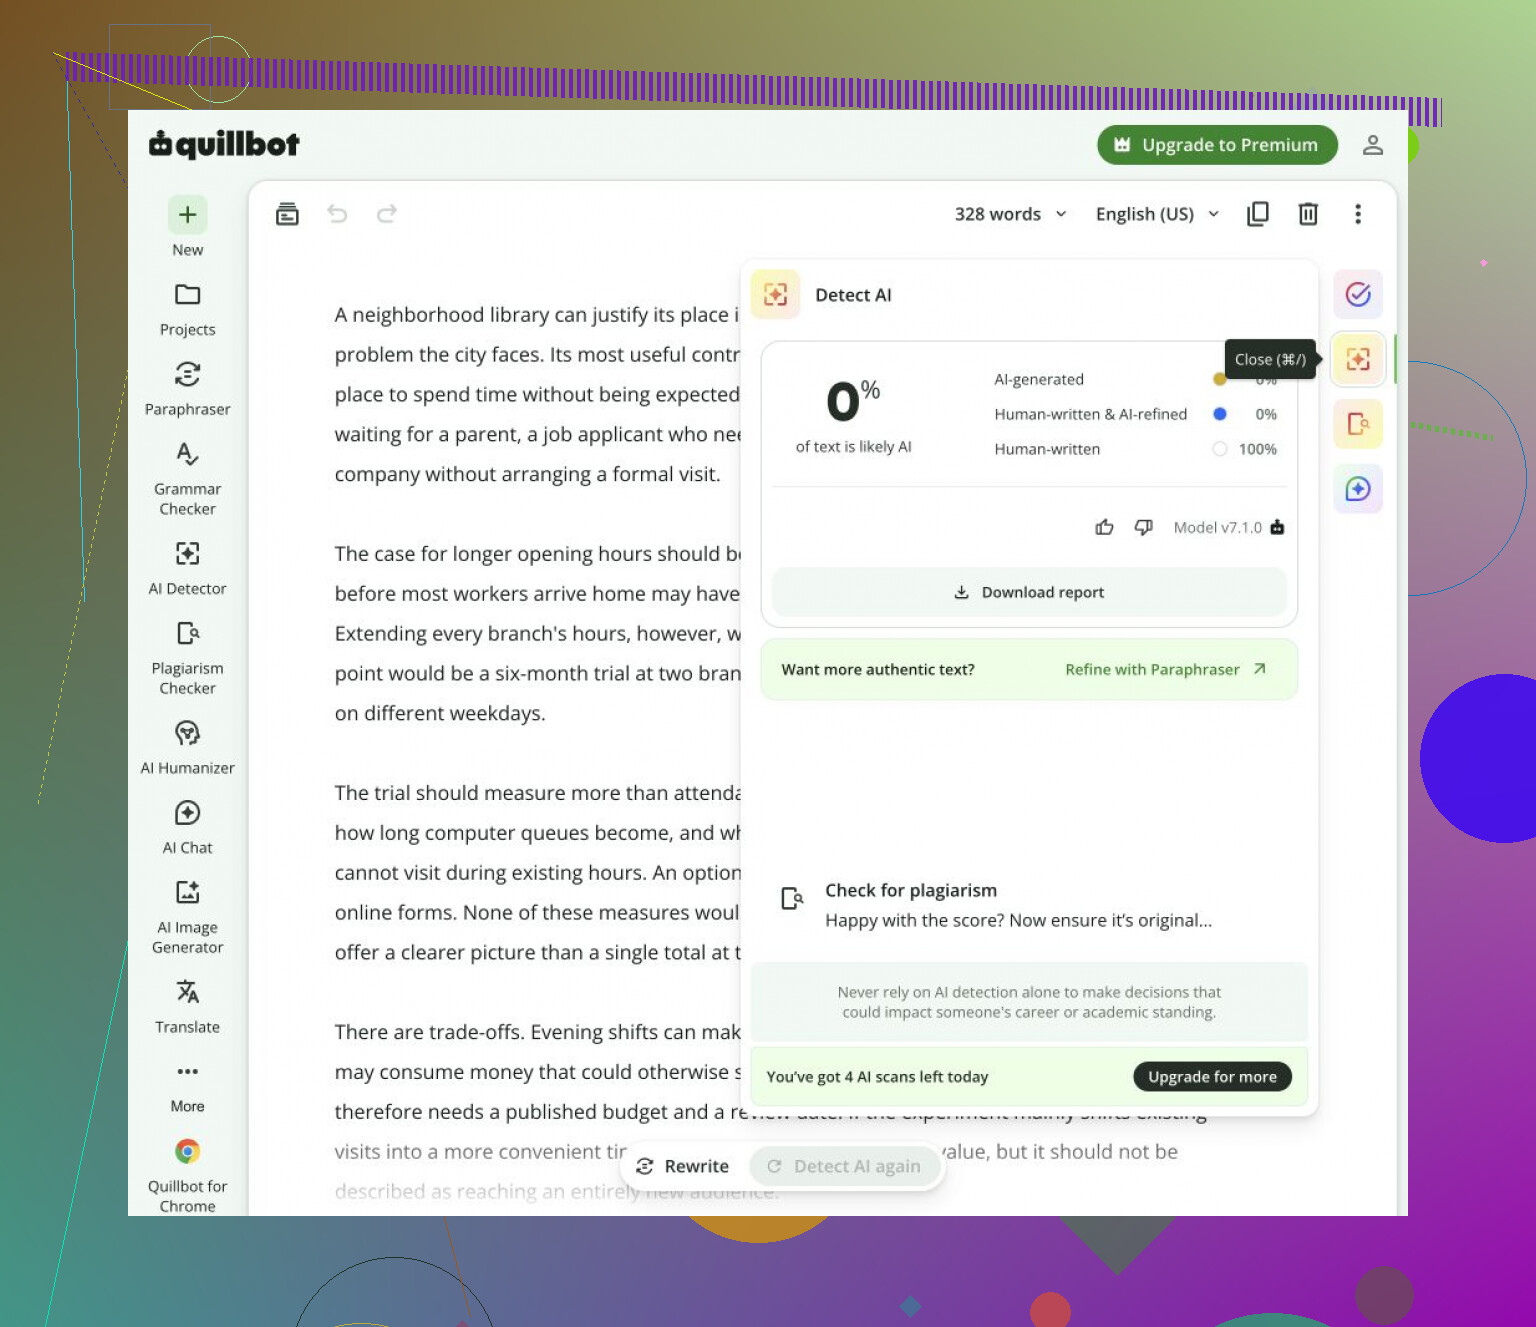
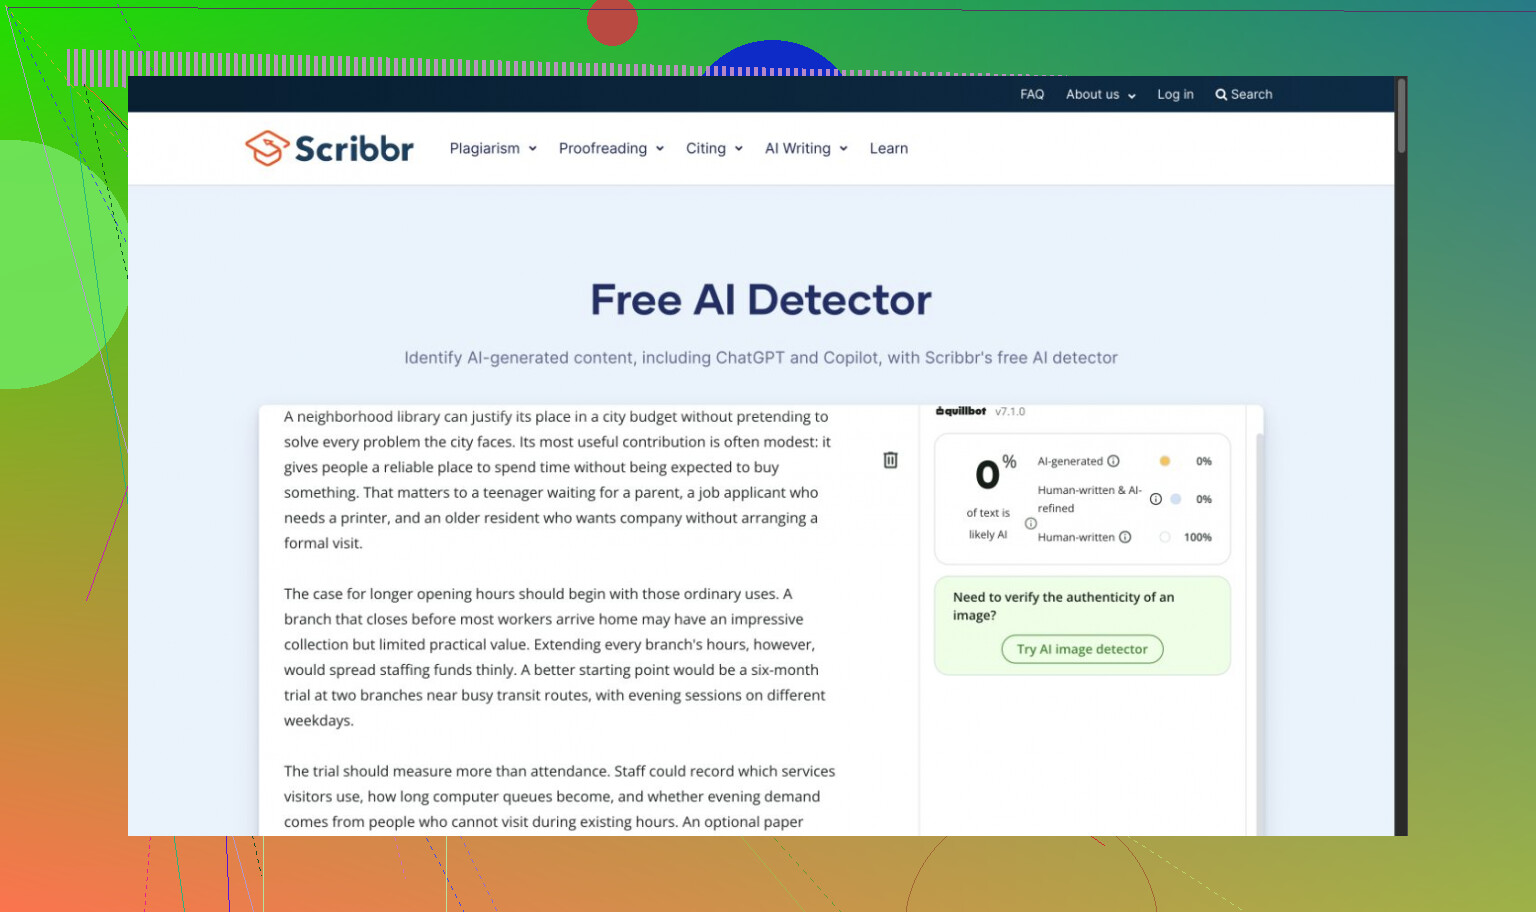
QuillBot aceptó los cuatro pasajes generados como humanos. Scribbr tampoco detectó el ensayo; la marca de QuillBot visible en su interfaz me impidió contarlo como un voto independiente.
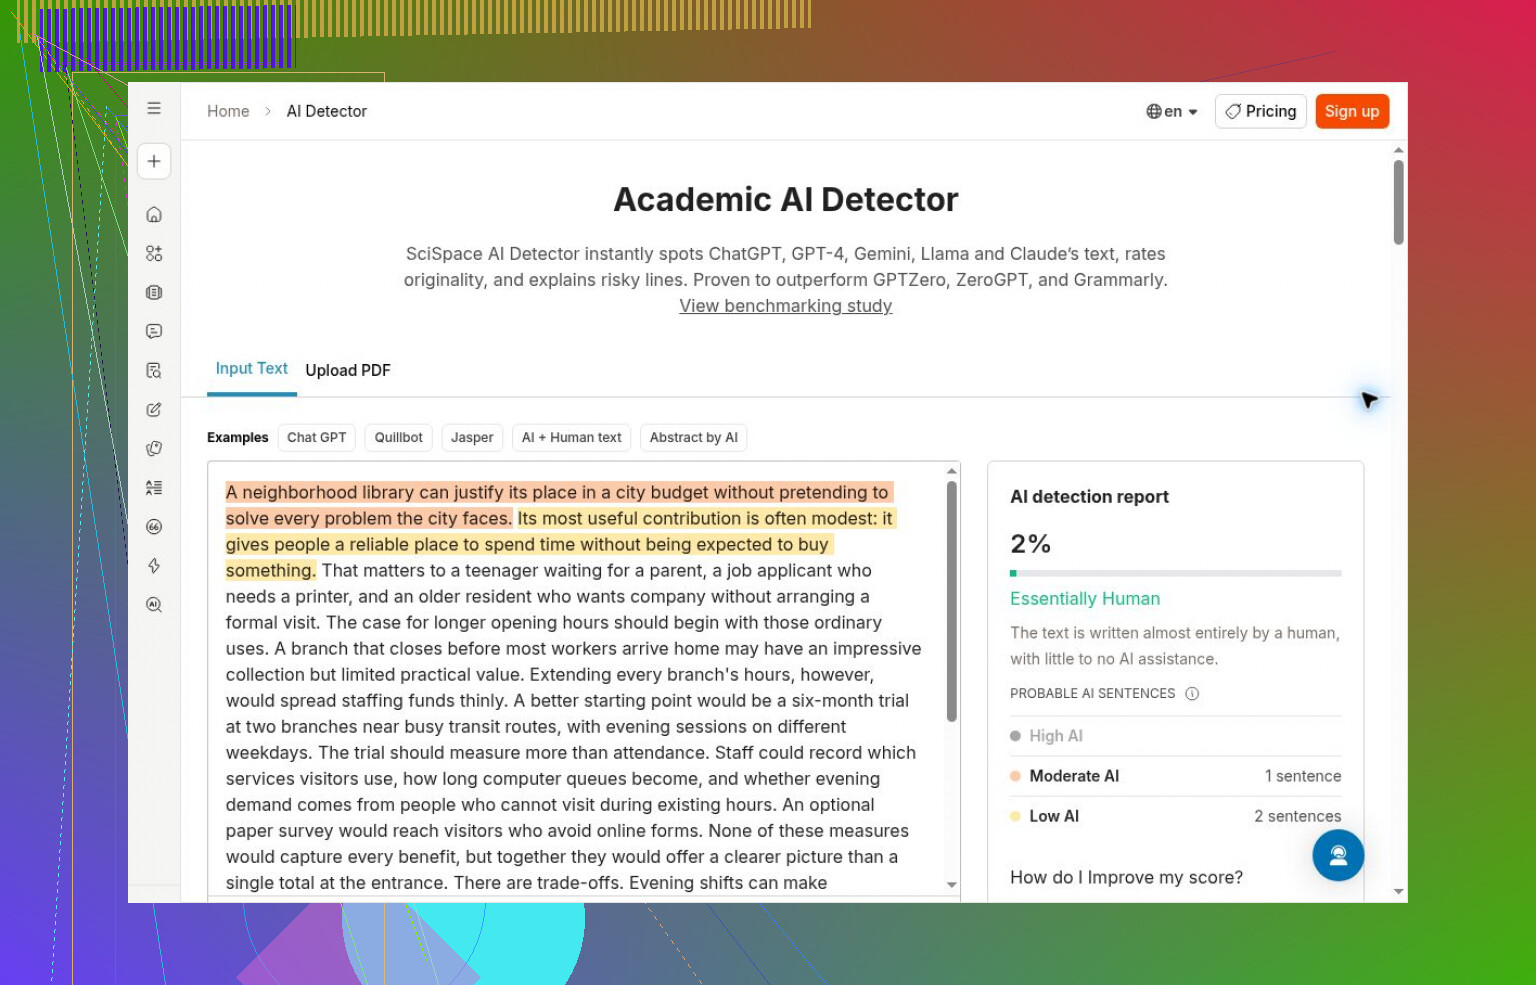
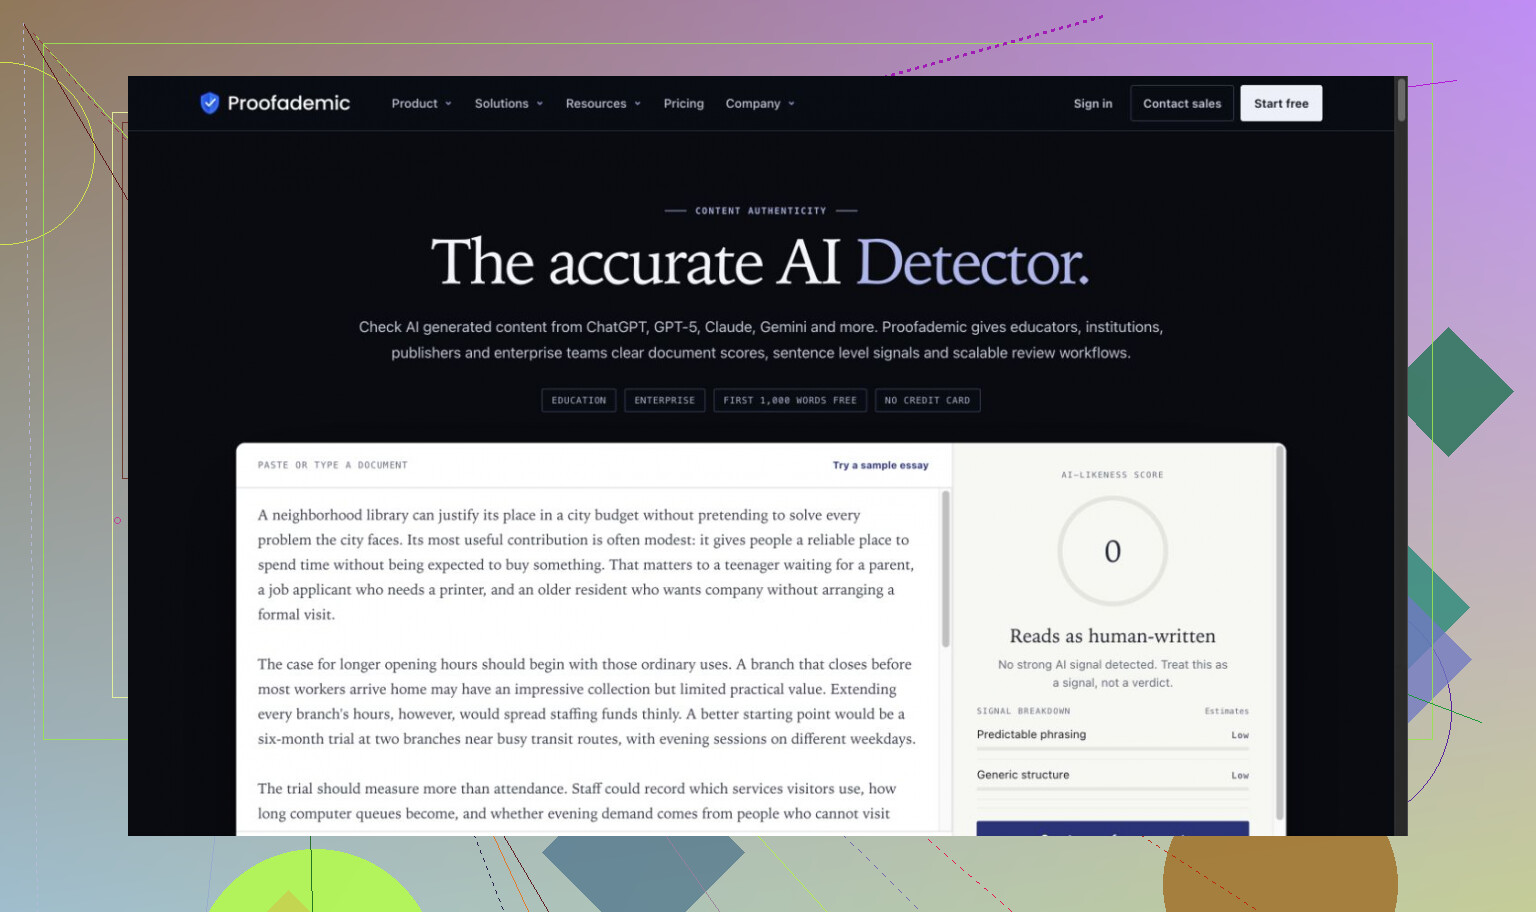
SciSpace y la demo pública de Proofademic tampoco detectaron el ensayo. Surfer aceptó los dos pasajes generados que comprobó. No pude determinar por qué.
Mi prueba completa con Clever AI Detector no requirió pago ni registro. Distinguió los pasajes generados del texto de Carroll, pero aceptó el fragmento editado como humano. No pude verificar el uso ilimitado anunciado, y las explicaciones por oración a veces contradecían el resultado principal.
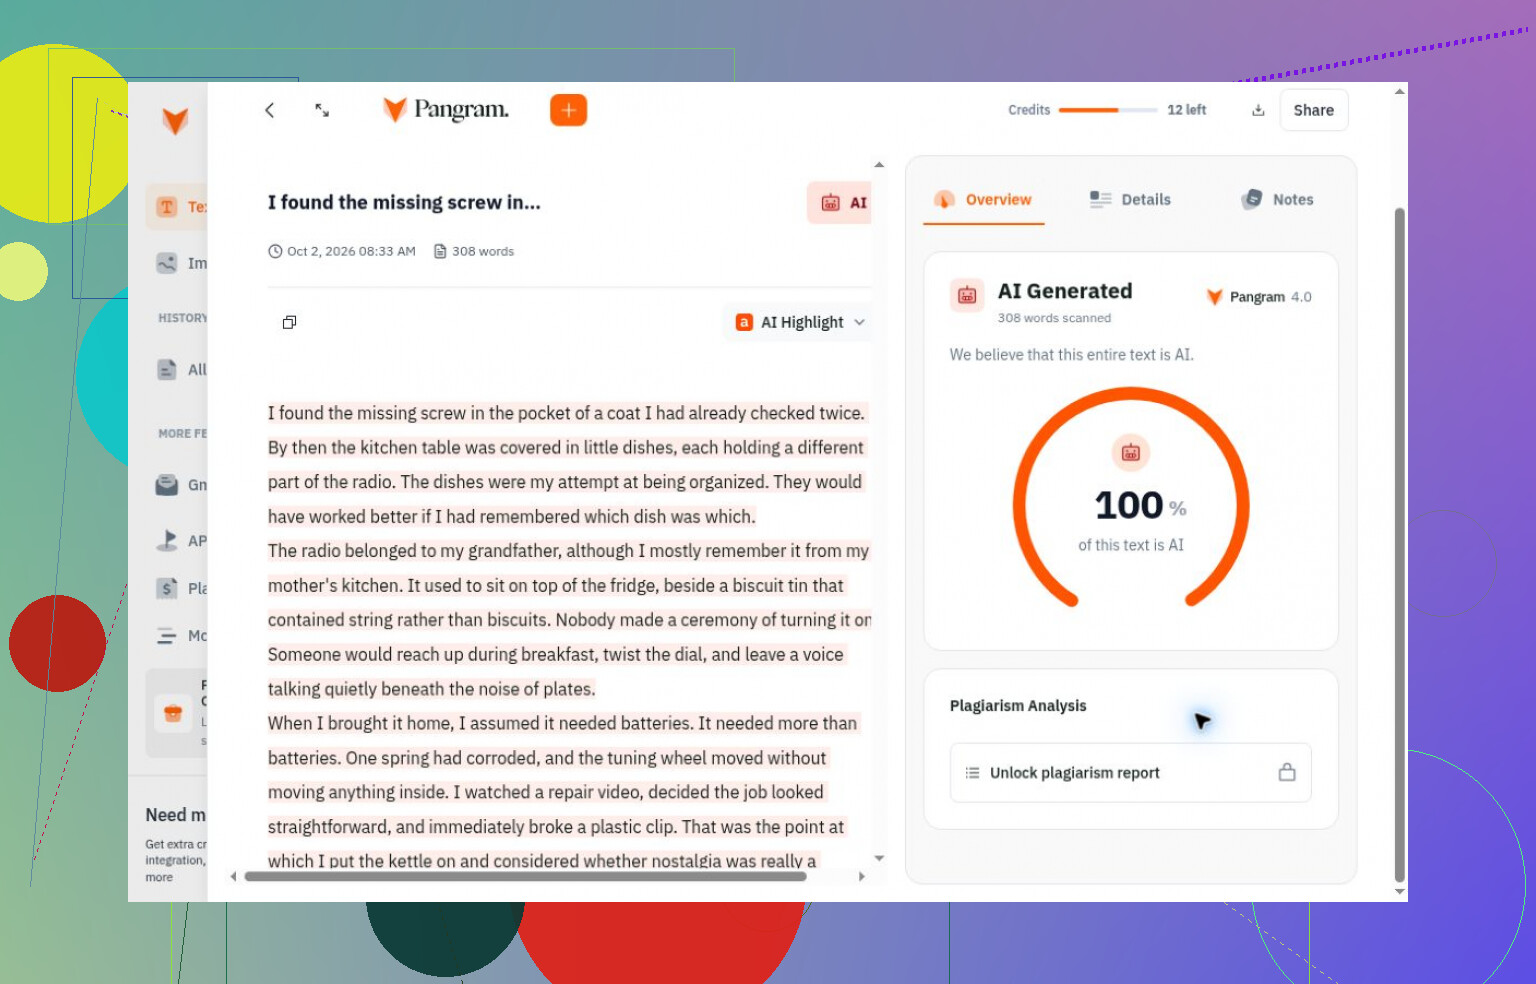
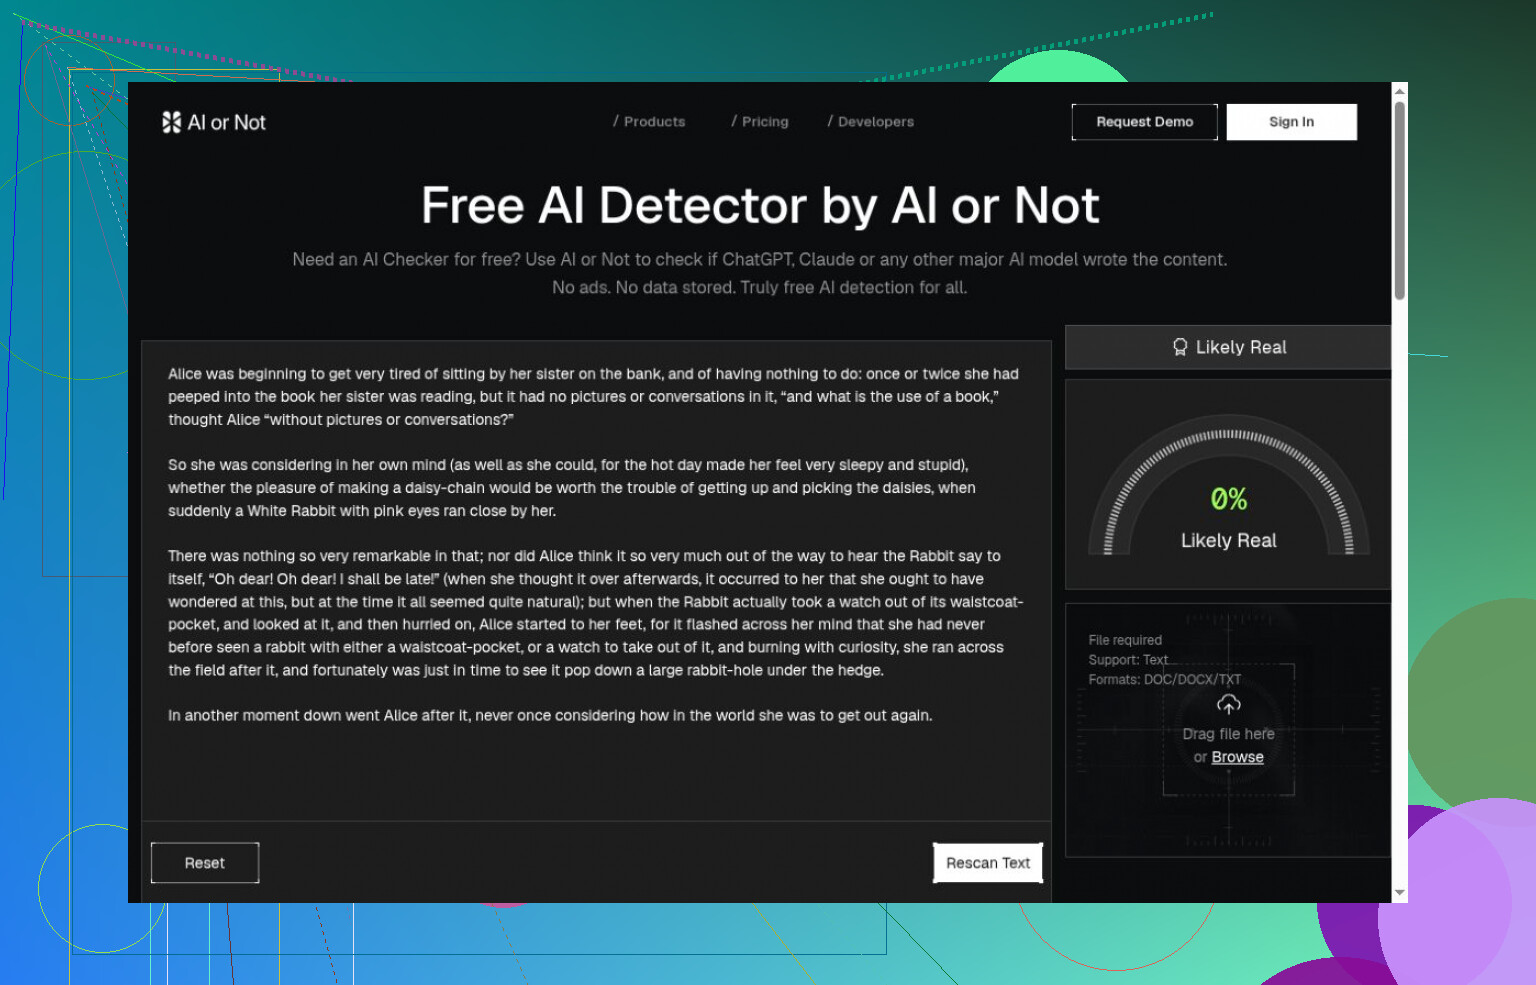
Pangram clasificó correctamente las muestras generadas y humanas cuyas comprobaciones completó, aunque los créditos se agotaron. También aceptó el fragmento editado como humano. AI or Not acertó en las comprobaciones que completó; allí no se probaron textos mixtos.
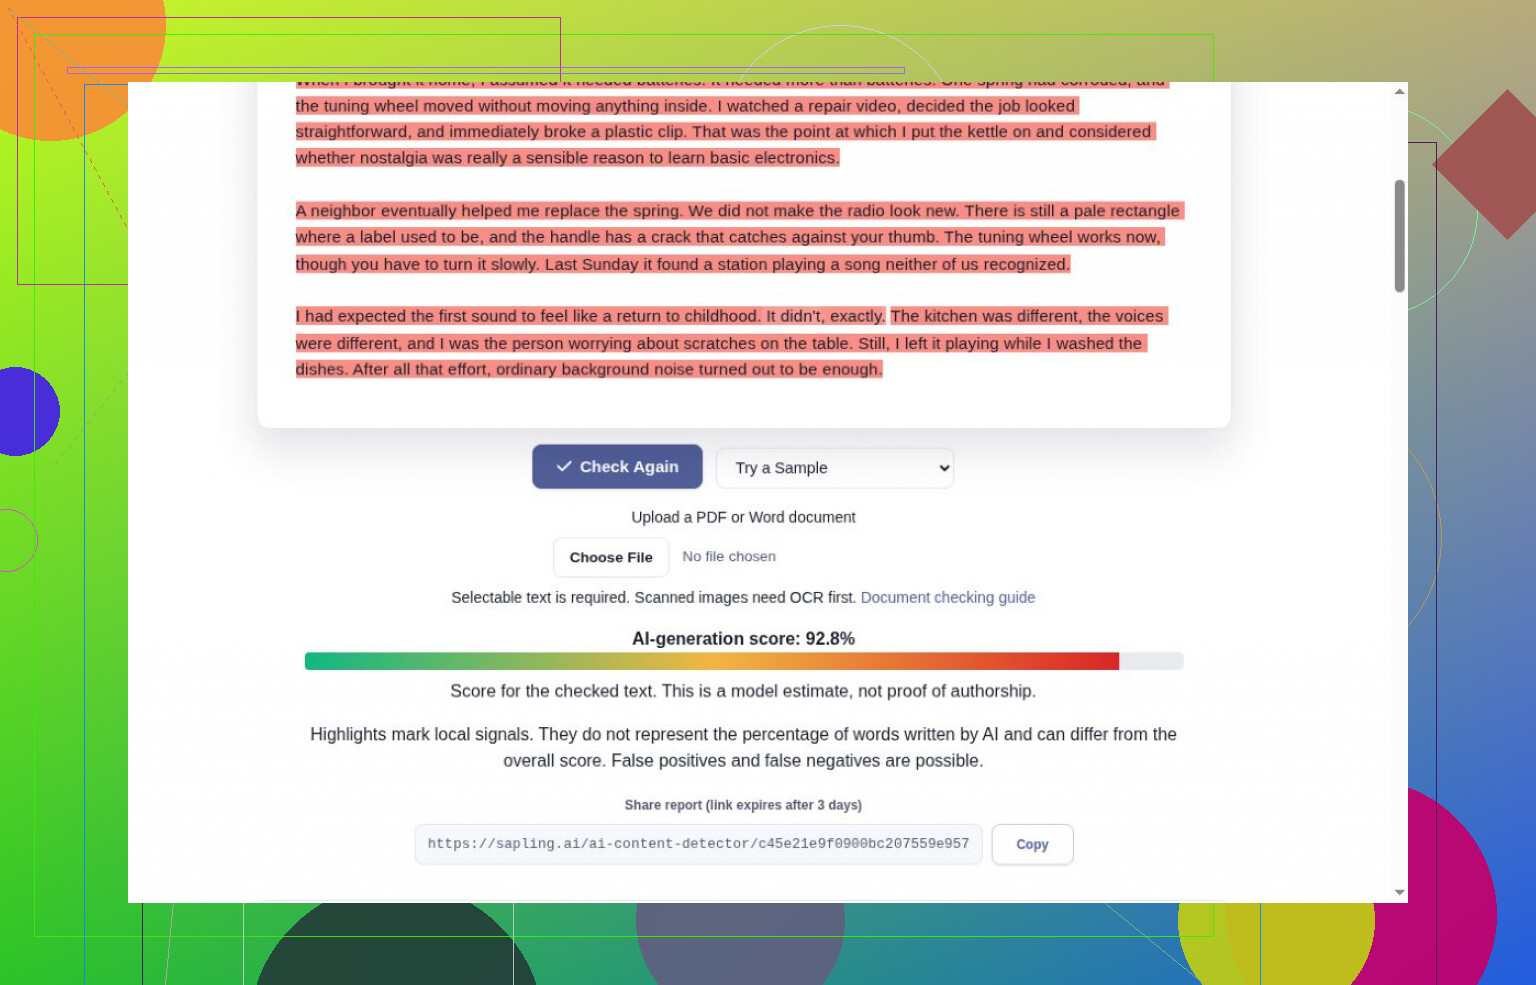
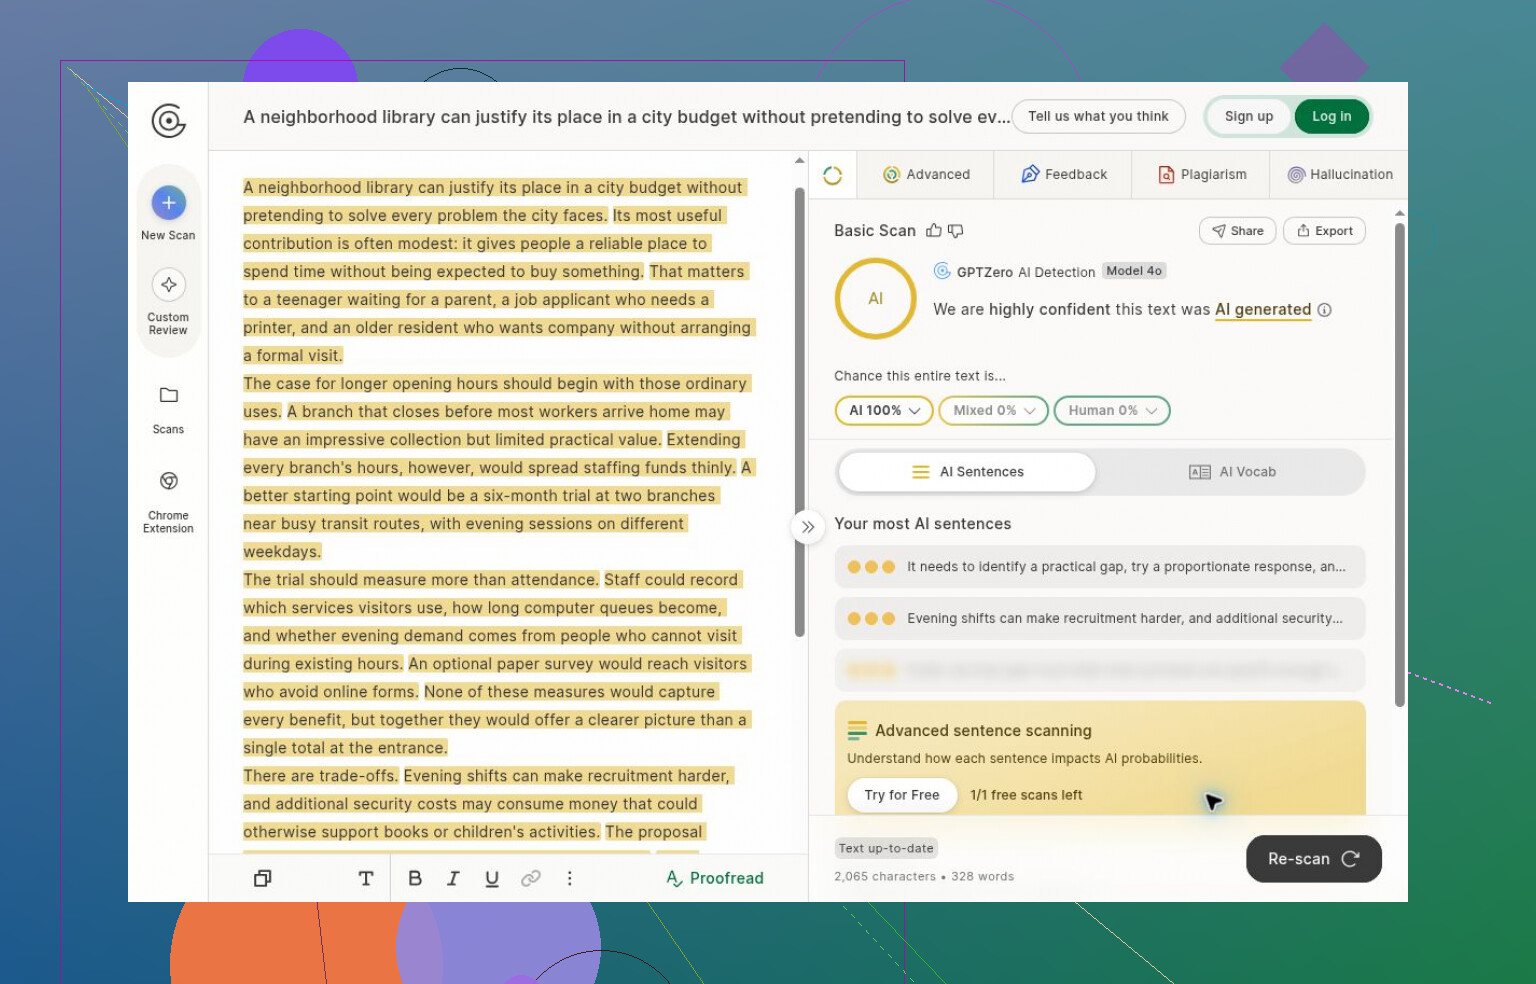
Sapling clasificó correctamente el relato completo y el texto de Carroll, pero truncó el ensayo. GPTZero detectó los textos generados que recibió antes de exigir el registro; al cambiar el texto, quedó una puntuación antigua en pantalla, no un resultado nuevo.
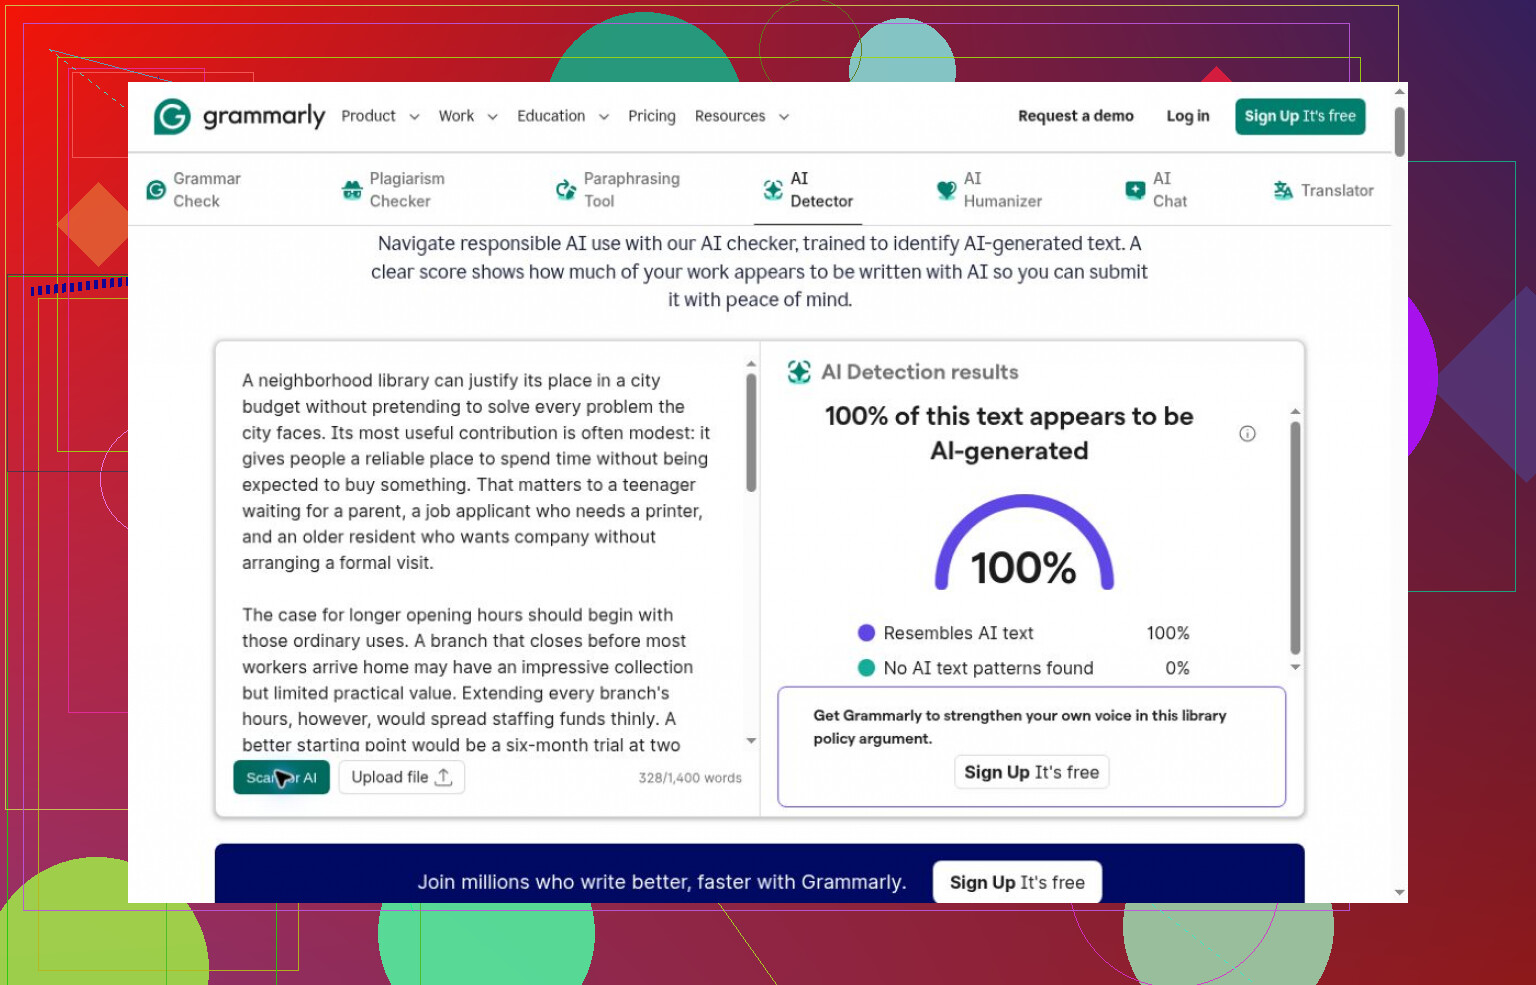
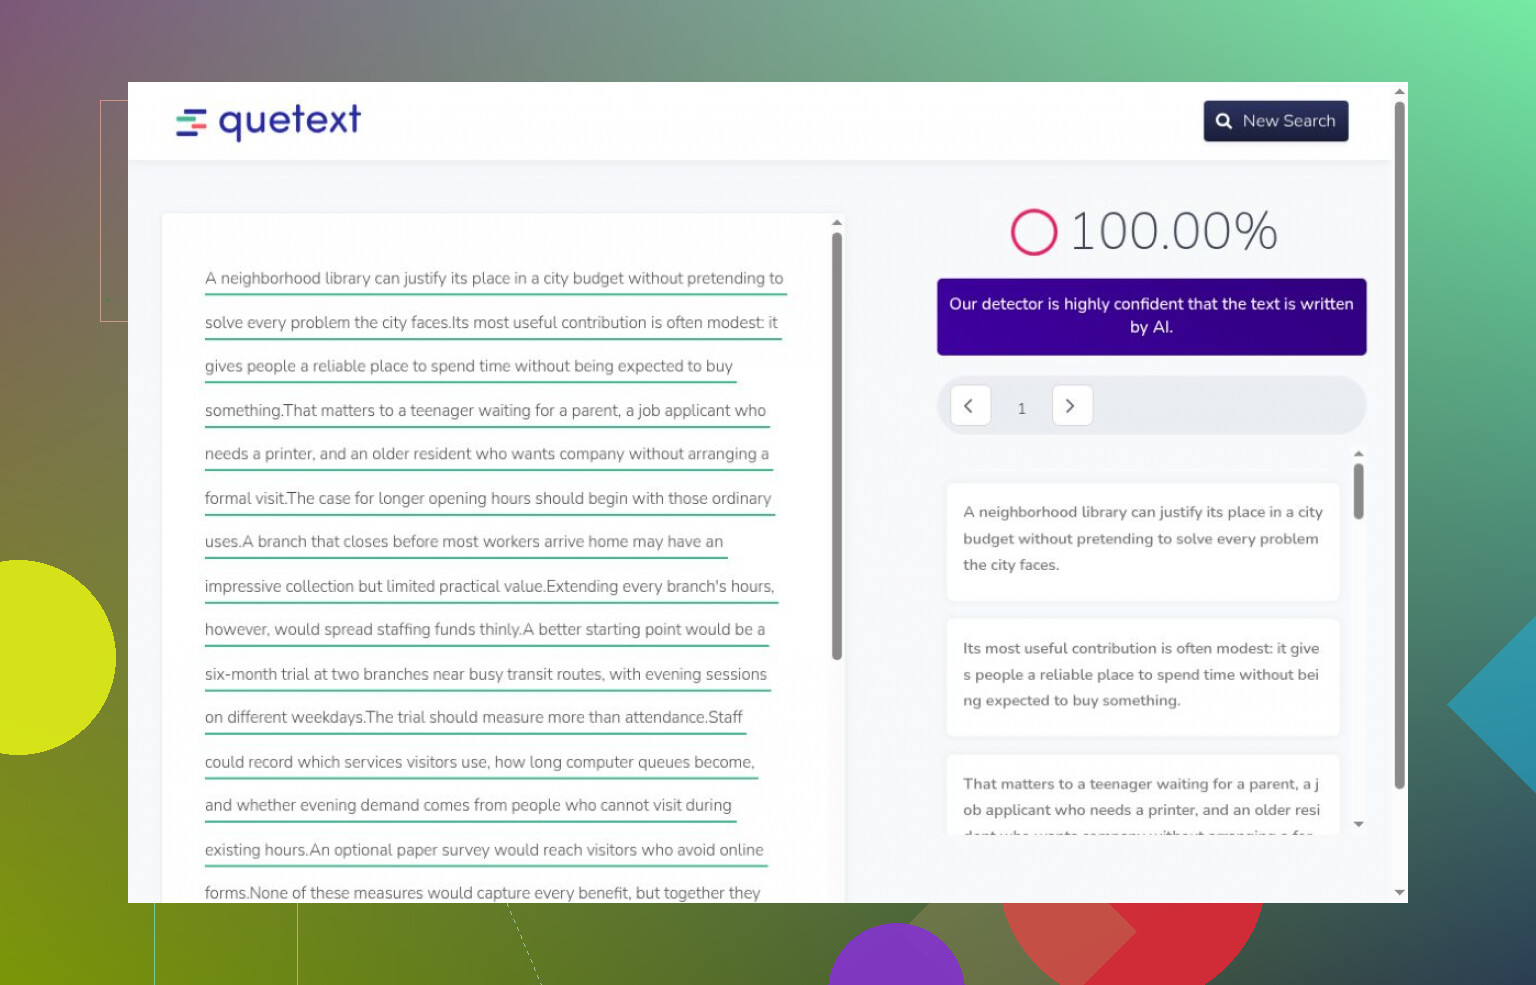
Grammarly y Quetext detectaron el ensayo y después bloquearon los intentos adicionales como invitado. Ninguno me dio un resultado para el texto humano de control.
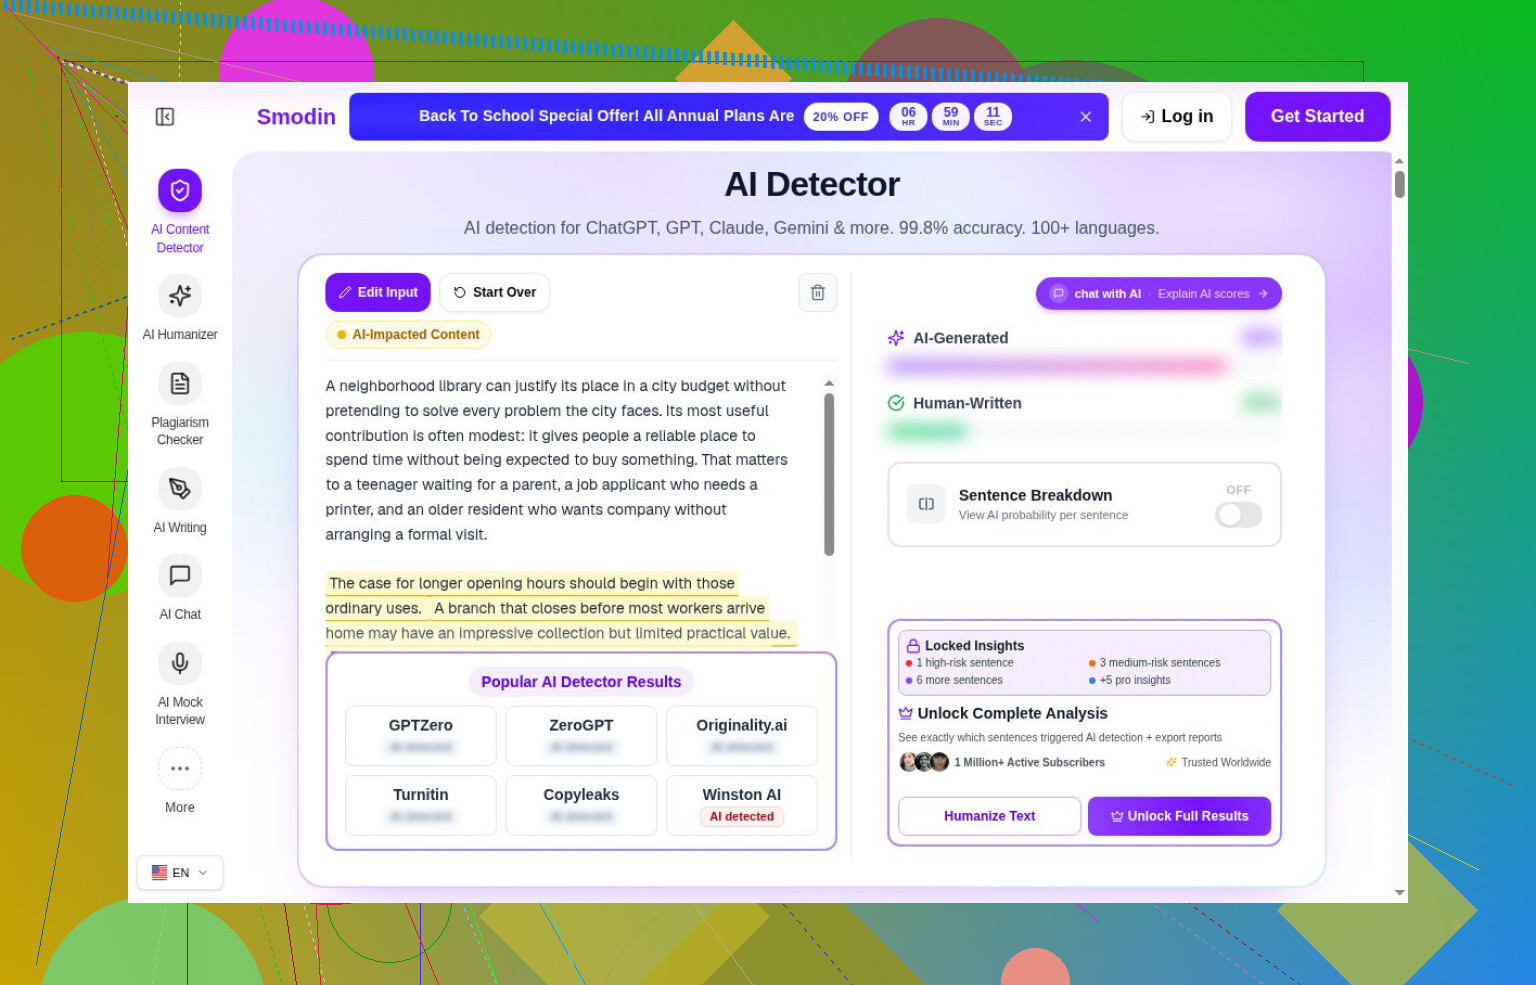
Decopy pidió iniciar sesión; Smodin ocultó sus valores principales. No pude evaluar ninguno de los dos.
AI Detector Pro y Winston AI exigían registrarse. Me detuve antes de analizar los textos, por lo que no verifiqué las cuotas de uso anunciadas.
Las condiciones de uso aplicables de Copyleaks detuvieron mi evaluación, no un análisis fallido. Turnitin requería un acceso institucional que no tenía.
La demo de Hive que examiné procesaba contenido multimedia; no configuré sus opciones de texto. ContentDetector.AI redirigía a una extensión de Moxby que no instalé.
La ficha de Humanly ofrecía una descarga gratuita con compras dentro de la aplicación. No verifiqué ni la cuota de análisis ni la detección.
Una puntuación sigue necesitando su etiqueta
No interpretaría la confianza, la probabilidad y la proporción estimada de IA como conceptos intercambiables. Originality.ai clasificó correctamente las muestras generadas y humanas cuyas comprobaciones completó, pero el acceso como invitado terminó antes de poder ampliar las pruebas. Seleccioné su ajuste de tolerancia de IA del 15 %; su nivel de confianza describía el veredicto basado en ese umbral, no la proporción de palabras generadas.